区块链中文技术社区

以太坊的几种同步模式

查看geth命令行参数geth --help

--syncmode value                    Blockchain sync mode ("snap", "full" or "light") (default: snap)

参数支持"full", "snap", "light" 三种模式「原先的"fast"已被 "snap"替代」

查看官方文档,

同步模式
--syncmode <mode> 您可以使用确定网络中节点类型的参数以三种不同同步模式之一启动 Geth 。

这些是:

  • Full : 下载所有区块(包括标题、交易和收据)并通过执行每个区块增量生成区块链的状态。
  • Snap(默认):与快速相同的功能,但具有更快的算法。
  • Light:下载所有区块头、区块数据,并随机验证一些。

官方推荐使用快照同步,简单说就是新的算法替代原先的fast模式,

请注意,快照同步已在 Geth v1.10.0 中提供,但尚未启用。
原因是提供快照同步需要节点已经生成快照加速结构,目前还没有,因为它也在 v1.10.0 中提供。
您可以通过 手动启用快照同步--syncmode snap,
但请注意,我们预计它要在柏林之后的几周内才能找到合适的对等方。
当我们觉得有足够的对等点可以依赖它时,我们将默认启用它。

此时已设置为默认模式

以太坊存档节点有什么用?

举个例子,如果你想知道4,000,000区块的以太坊账户余额,那么就需要运行存档节点,然后查询这个数字。这个节点依赖于一些专门的用例,但是对区块链的安全性和信任模型来说其实并没有影响。

内容引用

https://www.ccvalue.cn/article/2011.html

Golang中defer的实现原理

前言

在Go语言中,可以使用关键字defer向函数注册退出调用,即主函数退出时,defer后的函数才被调用。defer语句的作用是不管程序是否出现异常,均在函数退出时自动执行相关代码。 所以,defer后面的函数通常又叫做延迟函数

defer规则

1.延迟函数的参数在defer语句出现时就已经确定下来了

func a() {
    i := 0
    defer fmt.Println(i)
    i++
    return
}

返回结果:0
defer语句中打印的变量i在defer出现时就已经拷贝了一份过来,所以后面对变量i的值进行修改也不会影响defer语句的打印结果

注意:对于指针类型参数,规则仍然适用,只不过延迟函数的参数是一个地址值,在这种情况下,defer后面的语句对变量的修改可能会影响延迟函数

2.defer的执行顺序与声明顺序相反

简单理解就是:定义defer类似于入栈操作,执行defer类似于出栈操作,先进后出

3.defer可操作主函数返回值

defer语句中的函数会在return语句更新返回值后在执行。因为在函数中定义的匿名函数可以访问该函数包括返回值在内的所有变量。

func deferFuncReturn() (result int) {
    i := 1
    defer func() {
       result++
    }()
    return i
}

返回结果:2
所以上面函数实际返回i++值。

defer实现原理

注意:我会把源码中每个方法的作用都注释出来,可以参考注释进行理解。

数据结构

我们先来看下defer结构体src/src/runtime/runtime2.go:_defer

type _defer struct {
    siz     int32 //defer函数的参数大小
    started bool
    sp      uintptr // sp at time of defer
    pc      uintptr //defer语句下一条语句的地址
    fn      *funcval //需要被延迟执行的函数
    _panic  *_panic //在执行 defer 的 panic 结构体
    link    *_defer //同一个goroutine所有被延迟执行的函数通过该成员链在一起形成一个链表
}

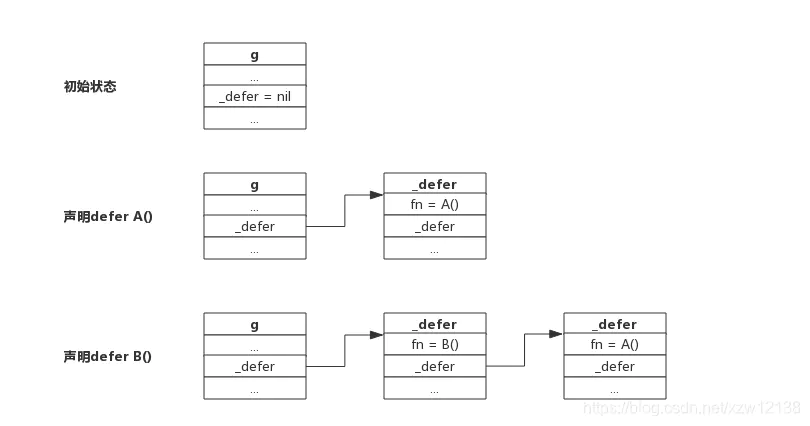
我们知道,在每一个goroutine结构体中都有一个_defer 指针变量用来存放defer单链表。
如下图所示:
defer的创建与执行

我们先来看一下汇编是如何翻译defer关键字的

    0x0082 00130 (test.go:16)   CALL    runtime.deferproc(SB)
    0x0087 00135 (test.go:16)   TESTL   AX, AX
    0x0089 00137 (test.go:16)   JNE 155
    0x008b 00139 (test.go:19)   XCHGL   AX, AX
    0x008c 00140 (test.go:19)   CALL    runtime.deferreturn(SB)

defer 被翻译两个过程,先执行 runtime.deferproc 生成 println 函数及其相关参数的描述结构体,然后将其挂载到当前 g 的 _defer 指针上。
我们先来看 deferproc 函数的实现

deferproc

// Create a new deferred function fn with siz bytes of arguments.
// The compiler turns a defer statement into a call to this.
//go:nosplit
func deferproc(siz int32, fn *funcval) { // arguments of fn follow fn
    //用户goroutine才能使用defer
    if getg().m.curg != getg() {
        // go code on the system stack can't defer
        throw("defer on system stack")
    }
    //也就是调用deferproc之前的rsp寄存器的值
    sp := getcallersp()
    // argp指向defer函数的第一个参数
    argp := uintptr(unsafe.Pointer(&fn)) + unsafe.Sizeof(fn)
    // 存储的是 caller 中,call deferproc 的下一条指令的地址
    // deferproc函数的返回地址
    callerpc := getcallerpc()

    //创建defer
    d := newdefer(siz)
    if d._panic != nil {
        throw("deferproc: d.panic != nil after newdefer")
    }
    //需要延迟执行的函数
    d.fn = fn
    //记录deferproc函数的返回地址
    d.pc = callerpc
    //调用deferproc之前rsp寄存器的值
    d.sp = sp
    switch siz {
    case 0:
        // Do nothing.
    case sys.PtrSize:
        *(*uintptr)(deferArgs(d)) = *(*uintptr)(unsafe.Pointer(argp))
    default:
        //通过memmove拷贝defered函数的参数
        memmove(deferArgs(d), unsafe.Pointer(argp), uintptr(siz))
    }

    // deferproc通常都会返回0
    return0()
}

比较关键的就是 newdefer

func newdefer(siz int32) *_defer {
    var d *_defer
    sc := deferclass(uintptr(siz))
    //获取当前goroutine的g结构体对象
    gp := getg()
    if sc < uintptr(len(p{}.deferpool)) {
        pp := gp.m.p.ptr()//与当前工作线程绑定的p
        if len(pp.deferpool[sc]) == 0 && sched.deferpool[sc] != nil {
            // Take the slow path on the system stack so
            // we don't grow newdefer's stack.
            systemstack(func() {//切换到系统栈
                lock(&sched.deferlock)
                //从全局_defer对象池拿一些到p的本地_defer对象池
                for len(pp.deferpool[sc]) < cap(pp.deferpool[sc])/2 && sched.deferpool[sc] != nil {
                    d := sched.deferpool[sc]
                    sched.deferpool[sc] = d.link
                    d.link = nil
                    pp.deferpool[sc] = append(pp.deferpool[sc], d)
                }
                unlock(&sched.deferlock)
            })
        }
        if n := len(pp.deferpool[sc]); n > 0 {
            d = pp.deferpool[sc][n-1]
            pp.deferpool[sc][n-1] = nil
            pp.deferpool[sc] = pp.deferpool[sc][:n-1]
        }
    }
    //如果p的缓存中没有可用的_defer结构体对象则从堆上分配
    if d == nil {
        // Allocate new defer+args.
        //因为roundupsize以及mallocgc函数都不会处理扩栈,所以需要切换到系统栈执行
        systemstack(func() {
            total := roundupsize(totaldefersize(uintptr(siz)))
            d = (*_defer)(mallocgc(total, deferType, true))
        })
        if debugCachedWork {
            // Duplicate the tail below so if there's a
            // crash in checkPut we can tell if d was just
            // allocated or came from the pool.
            d.siz = siz
            //把新分配出来的d放入当前goroutine的_defer链表头
            d.link = gp._defer
            gp._defer = d
            return d
        }
    }
    d.siz = siz
    d.link = gp._defer
    //把新分配出来的d放入当前goroutine的_defer链表头
    gp._defer = d
    return d
}

在函数deferproc中,

  • 先获得调用deferproc之前的rsp寄存器的值,后面进行deferreturn时会通过这个值去进行判断要执行的defer是否属于当前调用者
  • 通过newdefer 函数分配一个 _defer 结构体对象并放入当前 goroutine 的 _defer 链表的表头
  • 然后会将参数部分拷贝到紧挨着defer对象后面的地址:deferArgs(d)=unsafe.Pointer(d)+unsafe.Sizeof(*d)
  • 执行return0函数,正常情况下返回0,经过test %eax,%eax检测后继续执行业务逻辑。异常情况下会返回1,并且直接跳转到deferreturn

deferreturn

// 编译器会在调用过 defer 的函数的末尾插入对 deferreturn 的调用
// 如果有被 defer 的函数的话,这里会调用 runtime·jmpdefer 跳到对应的位置
// 实际效果是会一遍遍地调用 deferreturn 直到 _defer 链表被清空
// 这里不能进行栈分裂,因为我们要该函数的栈来调用 defer 函数
func deferreturn(arg0 uintptr) {
    gp := getg()
    // defer函数链表
    // 也是第一个defer
    d := gp._defer
    if d == nil {
        //由于是递归调用,
        //递归终止
        return
    }
    //获取调用deferreturn时的栈顶位置
    sp := getcallersp()
    // 判断当前栈顶位置是否和defer中保存的一致
    if d.sp != sp {
        //如果保存在_defer对象中的sp值与调用deferretuen时的栈顶位置不一样,直接返回
        //因为sp不一样表示d代表的是在其他函数中通过defer注册的延迟调用函数,比如:
        //a()->b()->c()它们都通过defer注册了延迟函数,那么当c()执行完时只能执行在c中注册的函数
        return
    }

    //把保存在_defer对象中的fn函数需要用到的参数拷贝到栈上,准备调用fn
    //注意fn的参数放在了调用调用者的栈帧中,而不是此函数的栈帧中
    switch d.siz {
    case 0:
        // Do nothing.
    case sys.PtrSize:
        *(*uintptr)(unsafe.Pointer(&arg0)) = *(*uintptr)(deferArgs(d))
    default:
        memmove(unsafe.Pointer(&arg0), deferArgs(d), uintptr(d.siz))
    }
    fn := d.fn
    d.fn = nil
    // 指向 defer 链表下一个节点
    gp._defer = d.link
     // 进行释放,归还到相应的缓冲区或者让gc回收
    freedefer(d)
    //执行defer中的func
    jmpdefer(fn, uintptr(unsafe.Pointer(&arg0)))
}

在函数deferreturn中

  • 判断当前goroutine上是否还有绑定的defer,若没有,直接return。若有,则获取链表头部的defer
  • 通过判断当前defer中存储的sp是否和调用者的sp一致,来证明当前defer不是在此调用函数中声明的。
  • 将保存在_defer对象中的fn函数需要用到的参数拷贝到栈上,准备调用defer后的函数
  • 释放defer
  • 通过jmpdefer函数执行defer后的func

总结

  • 在编译在阶段,声明defer处插入了函数deferproc(),在函数return前插入了函数deferreturn()
  • defer定义的延迟函数参数在defer语句出时就已经确定下来了
  • defer定义顺序与实际执行顺序相反
  • 对匿名函数采用defer机制,可以使其观察函数的返回值

转载自:https://www.jianshu.com/p/387ad32c6441
Mandel 将于 2022 年收购 EOSIO

自两年多前发布 EOSIO 2.0 以来,EOS 网络没有进行过重大升级。从那时起,block.one 产生了 EOSIO 2.1 和 EOSIO 2.2 的候选版本;然而,由于各种原因,Clarionos 团队和更广泛的 EOS 社区不希望所有代码都与最新版本捆绑在一起。

展望未来,Clarionos 团队会将 EOSIO 代码库分叉到一个新的代码库中,我们称之为 Mandel(Mandelbrot 的缩写)。在所有 EOSIO 驱动的区块链之间达成更广泛的共识之前,Mandel 名称是一个占位符。

Mandel 的第一个版本将是 3.0,并将从 EOSIO 2.0 派生,同时从 EOSIO 2.1 和 EOSIO 2.2 中挑选一些最有价值的增强功能。Mandel 3.0 还将引入两个新的硬分叉:合同支付、增强的可配置区块链参数。此外,它将从 EOSIO 2.1 中挑选可配置的 WASM 限制硬分叉。

虽然 EOS 区块生产者大部分仍使用 EOSIO 2.0,但一些 EOS 基础设施节点和其他下游软件已升级到 EOSIO 2.1。在迁移到 Mandel 3.0 之前要求这些节点“降级”到 EOSIO 2.0 可能会造成不必要的短期负担;因此,Clairionos 还将发布源自 EOSIO 2.1 的 Mandel 2.3 版本,该版本对 Mandel 3.0 启用的新硬分叉支持精选支持。EOSIO 2.1 节点应该能够无缝升级到 Mandel 2.3,同时与网络保持同步。
Clarionos 的目标是将尽可能多的 EOSIO 2.1 增强功能迁移到 Mandel 3.0,而不会延迟关键硬分叉的交付。

即将推出的硬分叉功能

1. 可配置的 WASM 限制

这种硬分叉允许区块生产者增加可以部署的智能合约的规模,这将允许部署更大、更强大的合约。出于安全目的,EOSIO 必须限制各种 wasm 参数,例如内存、函数数量等。一旦合约达到这些限制之一,开发人员就被迫将其代码划分为多个合约。早在 EOSVM 为 EOS 带来巨大的性能提升之前,就已经建立了最初的限制。我们现在认为增加这些限制是安全的。我们没有一次性增加,而是使它们可配置。这使网络有能力在未来扩展或在攻击者以某种方式利用额外容量时对其进行调整。

2. 合同支付

开发人员面临的最具挑战性的事情之一是使他们的应用程序易于使用。要求用户从网络租用 CPU、NET 和 RAM 资源以便与应用程序交互是一个主要的可用性障碍。在理想的世界中,智能合约将支付合约用户所需的所有资源。
当今存在的 EOS 要求每笔交易都必须由至少一个密钥签名,并且每个权限级别的阈值至少为 1。这限制了合约获取用户所需资源的潜力。
我们开发了一种不需要硬分叉的合同支付方法,但“黑客”涉及发布任何人都可以签名的“私人”密钥。当我们可以简单地允许相同的交易发生而没有任何密钥对其进行签名时,这会给网络带来不必要的负担。
在没有任何密钥的情况下可能发生的操作的一个示例是合约需要执行一些维护任务。合约愿意支付自己的维护费用,它不关心谁授权了交易。如果没有要执行的维护,那么合约将简单地拒绝交易并避免任何资源使用。维护任务的一个示例可能是当前由已弃用的延迟事务执行的许多任务。
通过合约支付,可以实现与比特币交易结构相同的交易。这消除了那些只想将 EOS 用作货币的人的帐户创建成本。它还将使实施 隐私令牌成为可能,而不会让您的隐私受到资源系统的损害。虽然这些事情将通过合同支付成为可能,但它们超出了当前路线图的范围。

有关合同付款的更多信息,请点击此处。

3. 增强的可配置区块链参数

这个硬分叉功能使添加/删除/配置未来的目标功能变得更加容易。不必为每个新功能或可配置参数添加新的本机内在函数,合约可以调用一个内在函数。这允许合约根据特征的存在或配置参数的值进行有条件的操作。此功能主要在 EOSIO 2.1 中实现,但经过审查,Clarionos 团队得出结论,需要进行一些小调整以确保更一致的操作。

系统合约升级

Clarionos 团队对 EOS 系统联系人有一个拉取请求,该请求将通过发布“私钥”来启用合同支付功能。这将允许应用程序在等待硬分叉生效的同时开发增强的用户体验。硬分叉后也需要利用该特性。

时间线

以下时间表是理想的,可能会随着发展的变化而变化。

  • 2022 年 1 月 31 日— Mandel 3.0 的候选版本
  • 2022 年 2 月— Mandel 3.0 测试网络启动和社区验证
  • 2022 年 3 月 1 日— Mandel 3.0 最终版本
  • 2022 年 3 月 2 日——网络部署 Contract Pays 系统合约
  • 2022 年 4 月 1 日——Mandel 2.3 发布
  • 2022 年 4 月 9 日——下一次伊甸园选举
  • 2022 年 5 月 19 日——硬分叉激活。(2022年的黄金分割率)

这将标志着 EOS 独立于 block.one 的象征性完成,因为这将是 EOS 网络第一次运行不是由 block.one 开发或发布的软件版本。
资金
EOS 网络基金会已与 Clarionos 达成协议(待区块生产者批准),在 Mandel 3.0 候选版本交付后(2022 年 1 月 31 日)向 Clarionos 支付 200,000 EOS。然后,Clarionos 将支持社区修复在测试阶段发现的任何错误。

未来方向

该路线图是 EOS 独立的最短路径,也是振兴 EOS 多年计划的第一步。您将在下一次路线图更新中看到的一些项目包括:3 秒确定性、加速 EVM 支持的内在函数以及加速隐私应用程序的内在函数。
EOS 即将以多年未见的速度加快发展速度。

原文地址:https://medium.com/edenoneos/eos-mandel-to-takeover-eosio-in-2022-2e25bf5451f0

EVM+:帮助EOS实现EVM兼容

引言:EVM+工作组正在采取行动,在EOS上部署以太坊虚拟机

概述

EOS正在凝聚社区力量共同开发生态所需的关键项目,从而进一步推动EOS生态的复苏。我们拥有才华横溢的开发人员,能够做出重大贡献的社区领袖,以及责任心和行动力都非常强的EOS网络基金会。
EOS正在开辟自己的前进道路,并开启一个新的协作时代。
目前,由EOS网络基金会资助成立的六大核心工作组正在高速运行,每个工作组都在其领域发挥重要作用,其中API+、Core+、Wallet+和Audit+四个工作组蓝皮书已接近完成,每份蓝皮书都是重要的研究成果,将详细阐述发展目标,各自领域如何取得成功的可行策略等。
今天,我们将带领大家认识EVM+核心工作组,在正式介绍之前,我们先来了解一下六大核心工作组的概况。

六大核心工作组介绍

目前,EOS网络基金会赞助成立了六个核心工作组,他们分别是:

  • API+:主要负责提供数据接口,帮助EOS生态以外的应用程序更好的集成EOS网络。
  • Core+:主要负责维护EOS系统使EOS更适合运行各种类别的应用程序。
  • Wallet+:主要负责配合软件将EOS集成到外部应用程序中。
  • Audit+:主要负责为EOS应用提供安全分析工具和合约审计的整体框架。
  • EVM+:主要负责实现与EVM的兼容以及探索EOS可行性的经济激励措施。
  • Recover+:主要负责建立危机处理框架,通过制定紧急联络、反应机制、DAO保险和白帽奖励等措施,帮助EOS项目在遭遇黑客攻击后以更合理有效的方式应对危机及追回丢失资产。

核心工作组将会与EOS生态中最有经验的人和组织合作,在落实EOS路线图方面发挥重要作用。这将是一个评估EOS生态现状、识别潜在问题并为未来发展制定路线图的绝佳机会。

每个工作组都收到了来自EOS网络基金会提供的20–25万美元的资助,另外EOS网络基金会还支出10万美元成立了一个监督小组,专门监督工作组的整体进展。

但出于社区呼声和生态需求的考虑,EVM+工作组与其他工作组的工作流程略有不同。在EOS Argentina的领导下,EVM+工作组将采取更敏捷的方式进行开发。

EVM+工作组不撰写蓝皮书,而是直接进行开发和产品交付,从而更快的在EOS智能合约层面实现EVM兼容。另外, EVM+工作组的初始预算资金为20万美元。

EVM+工作组介绍

EOS目前面临的最重要的问题之一是区块链的互操作性。
区块链领域最容易产生的问题是向内聚焦发展,而忽视了向外兼容取长补短,这样的问题在EOS表现的很明显。开发人员经常陷入一种思维逻辑:EOS拥有最好的技术,所以EOS是最好的地方,即使其他公链生态的人都还没有意识到EOS的潜力。

这样的想法会使EOS与更广阔的区块链世界隔绝开来,很容易坐井观天错过许多机会。许多开发者离开EOS,转投以太坊,原因就是虽然以太坊存在缺陷,但是却拥有更好的兼容性。

这也是我们成立EVM+工作组并加速这方面工作的重要原因,在EOS上部署以太坊虚拟机是一件非常重要的工作,我们需要推动EOS融入更广阔的区块链生态,不断的引进来、走出去,兼容并蓄快速发展。

从技术及业务角度来看,实现EVM兼容能够在释放EOS潜力方面发挥至关重要的作用。我们需要更多的以太坊开发者和用户加入EOS生态,而帮助EOS实现EVM兼容是吸引他们加入的最佳方式。

站在成功的肩膀上,吸引开发人才

EVM+工作组的领导团队是EOS创世区块生产者EOS Argentina,该团队也是Evodex和EOS Metamask钱包背后的开发人员。
为EVM+工作组提供协助的还有EOS生态的著名开发者Syed Jafri,他在2020年凭借EOSIO.EVM赢得了Block.one举办的EVM挑战赛, EOSIO.EVM使Solidity开发人员能够在EOSIO上快速启动并以高达100倍的速度和低于1000倍的成本运行应用程序。可以说,Syed Jafri在帮助EOS实现EVM兼容方面十分有经验。
EVM是EOS急需的创新。EOS公链在过去几年中面临的主要问题之一是资金匮乏。让我们和以太坊生态做一个对比:
以太坊速度更慢、效率更低而且Gas成本非常高,但以太坊和其他基于EVM的公链之间拥有更高的网络效应和代币流动性。另一方面,一部分以太坊上的开发人员能够通过创造基于Solidity编写的模块化、可重复利用、安全开源的智能合约获得高额回报,另一部分开发者可通过OpenZeppelin等组织的收录的代码库获得丰富的开发工具和教程。一个不可否认的事实是:EVM生态系统中的开发人员工具、代码库、可供dApp开发人员使用的开源代码一直在快速增长。
反观EOS生态,开发人员只能使用不太成熟的工具从头开始构建许多代码库,一个不恰当的比喻是:以太坊生态的开发者制造汽车就像是搭积木,把现成的车轮、方向盘、发动机等拼接在一起就好,而EOS生态的开发者想要制造汽车,需要从制造车轮开始。
EOS网络基金会赞助的其他工作组正在专注于改善EOS开发人员的体验,提供更多可用的本地工具,但都需要一些时间才能充分实现。
因此,我们和社区都认为,我们可以利用EVM已经存在的人才和资源,并通过EVM兼容将这些引入EOS,以此挖掘出EOS生态的潜力。
EOS发展已经进入极其重要的一年,EOS仍然面临两个巨大挑战:
一方面,EOS必须向潜在的开发者展示其巨大的潜力和价值;
另一方面,EOS必须消除开发者进入生态的障碍,尽可能降低门槛,吸引更多开发者加入。
即使项目方或开发人员相信EOS更好,但如果进入EOS生态的过程漫长、繁琐,项目方和开发人员也不会加入。因此帮助其他公链的开发人员以无障碍、低门槛的方式,将项目部署、迁移或克隆到EOS生态,是更行之有效的方式。
EVM+工作组:在EVM和EOSIO之间架起桥梁
EVM+的总体目标是从开发人员和用户的角度,使EOS成为一个兼容的EVM平台。为此,以下是工作组正在解决的关键问题:
智能合约级别的兼容与本地节点实施:EOS Argentina正在努力开发基于智能合约的解决方案,使 EVM 能够在 EOS VM WASM 运行时正常运行。 这将允许EOS网络在不进行协议升级的情况下升级EVM运行(无需分叉)。
ETH 预编译合约:这不仅有利于EOS上的EVM,同时也有利于智能合约开发人员。 EOS与其他链一样,交易执行时间有限(协议为150毫秒,BP为30毫秒)。 尽管EOS VM功能强大且速度很快,但仍有一些类型的操作在Web汇编中执行时,缺乏它们在本机代码中可以进行的优化。 为了加快速度,EVM+工作组正在寻求将ETH预编译实现为EOS内在函数(本地代码)。
完全兼容RPC:该领域的计划仍在开发中,但EVM+团队的目标是至少支持大多数RPC,以允许在ETH上使用通用工具/开发环境。这将是该计划最重要的工作之一。
确定性Gas消耗/计费:EOS链使用三种资源:CPU(主观度量/可变价格)、NET(客观度量/可变价格)和RAM(客观度量/可变价格)计费。这方面工作的挑战是为用户提供确定性的Gas消耗和有竞争力的Gas价格,同时防止Web3 API被滥用。
支持Metamask:这意味着EOS生态将支持Metamask钱包,以便EOS本地合约和使用Solidity编写的EVM合约进行交互。
EVM+工作组将按照上述方向快速推进工作,为EOS实现EVM兼容创建最佳解决方案,并计划在2022年夏天之前产生切实可行的解决方案。
目前的六个工作组正在构建一个框架,使开发人员和用户更容易参与EOS,促进EOS网络的增长,使EOS生态系统更具吸引力。 EOS的未来从未如此光明。 我们邀请您加入我们,共同创造区块链世界最伟大的公链回归故事。
请继续关注EOS网络基金会赞助的其他工作组的深入研究。
关于EOS网络基金会
EOS网络基金会是一个非营利性的组织,旨在倾听社区声音、传达社区意愿并扶持社区优质项目发展,成为EOS社区的信息共享桥梁,并为EOS生态提供资金、技术、运营、未来规划、生态构建等关键基础设施支持,进一步发挥EOS作为世界上速度最快的治理型区块链的全部潜力。
EOS网络基金会Discord
EOS网络基金会中文Twitter
EOS网络基金会中文Medium
EOS网络基金会中文电报订阅号
EOS网络基金会中文电报群

https://medium.com/eos-network-foundation/evm-bringing-the-ethereum-virtual-machine-to-eos-f26b88466d99